Embeddings: cosa sono davvero e come li uso in produzione
 Yuri Perfetti4 min di lettura4 letture
Tempo di lettura: 7 minuti — Livello: intermedio
Perché tornarci sopra
Nell'articolo sul RAG ho introdotto gli embedding di sfuggita: "testo → vettore che ne cattura il significato". Bastava per capire il RAG, ma gli embedding meritano un articolo tutto loro — perché sono il mattone più sottovalutato di tutta l'IA applicata, e perché una volta capiti li vedi utili ovunque, non solo nella ricerca semantica.
Questo è quello che ho capito usandoli in produzione, spiegato senza matematica.
L'intuizione: una mappa del significato
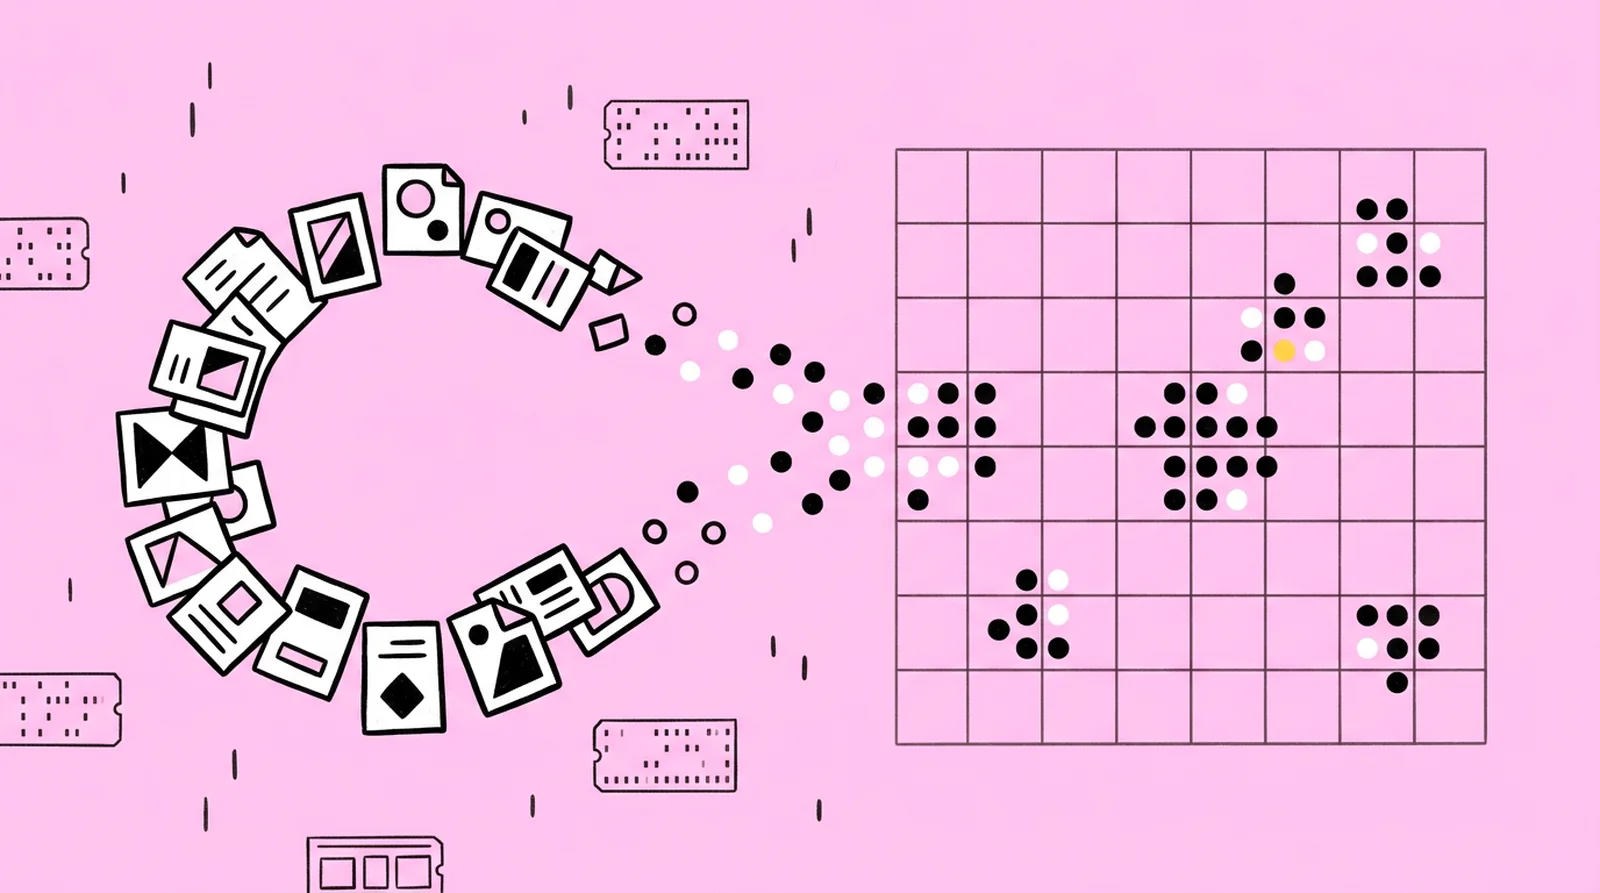
Immagina una mappa geografica gigantesca dove, invece delle città, ci sono i significati. "Fattura" e "ricevuta" sono due paesini vicini; "fattura" e "giraffa" stanno su continenti diversi. Un embedding è l'indirizzo di un testo su questa mappa: una lista di numeri (le "coordinate") — tipicamente centinaia o migliaia.
Le proprietà che rendono la mappa magica:
- La vicinanza è somiglianza di senso, non di lettere. "Come disdico il contratto?" e "procedura di recesso" abitano nello stesso quartiere pur non condividendo una parola.
- La mappa è multilingue (con i modelli giusti): "cane" e "dog" stanno praticamente allo stesso indirizzo.
- Le distanze si calcolano. Dati due indirizzi, un'operazione matematica banale ti dice quanto sono vicini. Ed è tutto ciò che serve per costruire cose utili. Come si ottiene l'indirizzo? Lo chiedi a un modello di embedding via API: mandi il testo, ricevi il vettore. Costo: frazioni di centesimo. È l'API più economica e più sottoutilizzata dell'intero catalogo IA.
Errore concettuale da evitare subito
Gli embedding non sono compressione del testo: dal vettore non si torna alle parole. Sono una proiezione del significato, fatta per una sola cosa: essere confrontata con altri vettori. Se ti serve il testo, il testo va salvato accanto al vettore — per questo nel mio RAG ogni riga di database ha entrambi.
Dove li uso davvero
-
Ricerca semantica (il classico). La knowledge base interrogabile in linguaggio naturale — ne ho scritto nell'articolo sul RAG. È il caso d'uso principe, ma fermarsi lì è un peccato.
-
Deduplicazione intelligente. Il mio workflow di monitoraggio news riceve la stessa notizia da fonti diverse, con titoli diversi. Il confronto tra URL non la becca; il confronto tra embedding dei titoli sì: se due titoli hanno similarità altissima, sono la stessa notizia vestita diversa, e la seconda si scarta. Dieci righe di logica, rassegna stampa senza doppioni.
-
Classificazione senza addestrare nulla. Vuoi smistare testi in categorie? Metodo tradizionale: addestrare un classificatore. Metodo embedding: calcoli il vettore di ogni categoria (usando una descrizione della categoria stessa), poi per ogni testo in arrivo prendi la categoria col vettore più vicino. Zero addestramento, e per aggiungere una categoria basta... aggiungerla. Per lo smistamento grossolano è imbattibile nel rapporto sforzo/risultato; sotto una soglia di confidenza, il caso passa a un modello linguistico vero (o a un umano).
-
Il radar dei "casi mai visti". Il più sottile: se un nuovo input è lontano da tutto quello che hai in archivio, è per definizione qualcosa di anomalo — una richiesta mai ricevuta, un tipo di email nuovo. La distanza dal vicino più prossimo diventa un campanello: "questo è diverso dal solito, guardalo tu".
Le lezioni di produzione
Il modello di embedding è un matrimonio. I vettori di modelli diversi non sono confrontabili tra loro: se cambi modello, ri-vettorizzi tutto l'archivio. Scegline uno mainstream e tienilo; la migrazione è il costo nascosto di questa tecnologia. (E salva sempre, accanto ai vettori, quale modello li ha generati: il te stesso del futuro ringrazia.)
La soglia di similarità si tara sui tuoi dati, non sui numeri altrui. "Sopra 0,8 sono simili" letto in un tutorial non vale niente: la distribuzione delle distanze dipende dal modello e dal dominio. Il metodo giusto: prendi venti coppie di testi tuoi di cui conosci la risposta (simili/diversi), guarda i punteggi, e la soglia emerge da sola.
Ciò che embeddi determina ciò che trovi. Vettorizzare il titolo, il testo completo o un riassunto produce mappe diverse. Per la deduplicazione delle news uso i titoli (veloce, sufficiente); per la knowledge base i frammenti completi. Non c'è la scelta giusta in assoluto — c'è quella coerente con la domanda che farai dopo.
Il quadro d'insieme
Se i modelli linguistici sono il "cervello che scrive", gli embedding sono il senso dell'orientamento: sanno dire cosa assomiglia a cosa, a costo irrisorio e velocità istantanea. I sistemi migliori che ho costruito usano entrambi, ciascuno per il suo mestiere: gli embedding per trovare, filtrare e smistare; il modello linguistico solo dove serve davvero ragionare. Il costo crolla, la velocità sale — e l'architettura, curiosamente, diventa più leggibile: ogni componente fa una cosa sola.
Che poi, a ben vedere, è sempre la stessa lezione di tutti questi articoli.
Questo articolo fa parte della serie "Sviluppare con l'IA" su perfetti.tech — dove racconto quello che costruisco davvero, errori compresi.
Hai un problema simile?
Mandami due righe: ti dico se ha senso trasformarlo in uno strumento vero e quanto tempo serve.
ScrivimiAltri articoli
- Webhook n8n aperto a tutti? Come proteggerlo in 4 mosse
Un webhook n8n senza protezioni parte per chiunque conosca l'URL. Quattro mosse semplici, senza codice, per chiuderlo a chiave.
- Copertine con l'AI: automatiche, ma con l'occhio umano
Come ho dato una copertina a 21 articoli con l'AI e automatizzato le prossime: costi, colori da correggere, errori sui dettagli e controllo umano.
- Automazione n8n o agente AI? Quando usare cosa
Che differenza c'è tra un'automazione n8n e un agente AI? Spiegazione semplice, esempi per piccole attività e una guida su quando usare cosa.
Commenti
Ancora nessun commento. Scrivi il primo.