Un parser email → Firestore per i prezzi dell'energia
 Yuri Perfetti4 min di lettura1 lettura
Tempo di lettura: 7 minuti — Livello: intermedio
Il problema: i dati che arrivano via email
C'è una verità del lavoro d'ufficio che nessun manuale di data engineering ammette: una quantità enorme di dati aziendali viaggia dentro le email. Listini, offerte, aggiornamenti prezzi — informazioni strutturate nella testa di chi le manda, che diventano testo libero nel momento in cui premono Invio.
Il mio caso: nel settore energia i fornitori comunicano periodicamente i prezzi aggiornati via email. Quei numeri mi servono dentro un'applicazione — un preventivatore che deve fare i conti con i prezzi correnti. Il flusso manuale era: apri l'email, trova i numeri, aggiorna l'applicazione. Ogni volta. Con il rischio classico: il preventivo fatto coi prezzi del mese scorso.
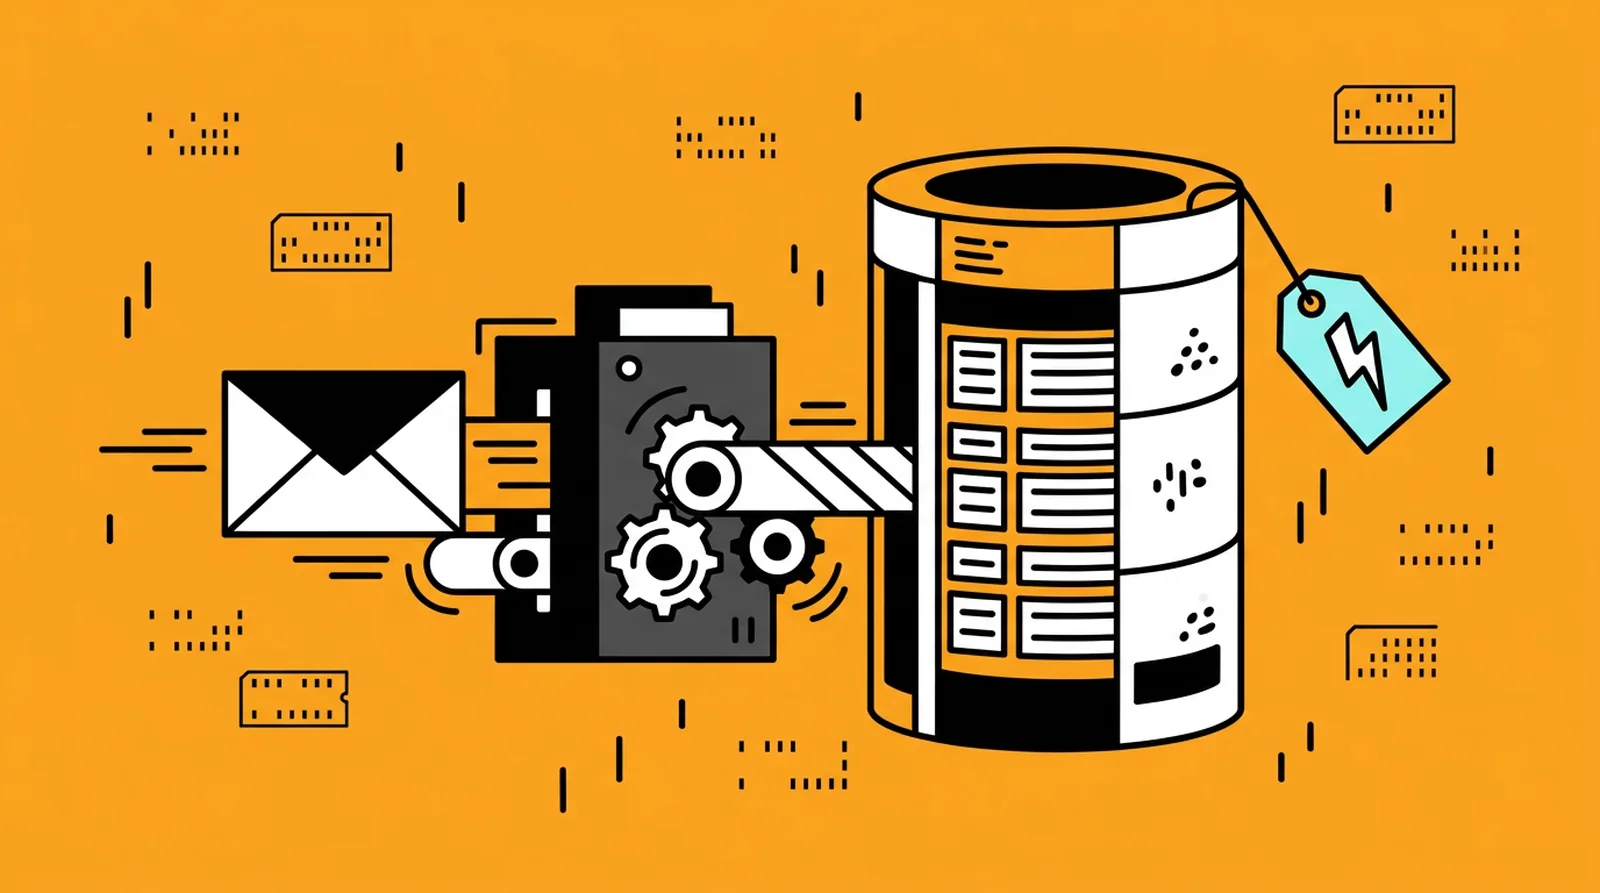
Il flusso automatico: email in arrivo → n8n la legge → l'IA estrae i prezzi → Firestore li salva → l'app li usa. Vediamo i pezzi.
L'architettura
Gmail Trigger (nuova email dal mittente X)
   │
   ▼
Filtro (è davvero un'email di listino?)
   │
   ▼
Estrazione IA (testo libero → JSON di prezzi)
   │
   ▼
Validazione (i numeri hanno senso?)
   │
   ▼
Firestore (l'app legge da qui)
   │
   ▼
Notifica Telegram (report di cosa è cambiato)
Il trigger: ascoltare la casella giusta
n8n ha il trigger Gmail nativo: si attiva sulle nuove email, filtrabili per mittente. Primo consiglio pratico: filtra il più possibile già nel trigger (mittente, oggetto), e aggiungi comunque un secondo filtro nel workflow. I fornitori mandano anche auguri di Natale e comunicazioni commerciali dallo stesso indirizzo — e non vuoi che il tuo parser cerchi prezzi dentro una newsletter.
L'estrazione: perché l'IA e non le regex
La tentazione dell'informatico classico: espressioni regolari che pescano i numeri dal testo. Funziona benissimo... finché il fornitore non riformula l'email, cambia l'ordine delle tariffe, o passa da tabella a elenco puntato. Le email sono scritte da umani per umani: il formato è una cortesia, non un contratto.
Un modello linguistico invece legge come un umano. Il prompt che uso è il solito pattern dell'estrazione strutturata:
"Questa è un'email di aggiornamento prezzi energia. Estrai le tariffe e rispondi SOLO con JSON in questo formato: {"luce": {"f1": 0.000, ...}, "gas": {...}, "decorrenza": "YYYY-MM-DD"}. Se un valore non è presente, usa null. Non aggiungere testo fuori dal JSON."
Il campo decorrenza merita una nota: i listini hanno una data di validità, che spesso non coincide con la data dell'email. Estrarla e salvarla è la differenza tra "ho i prezzi" e "so quali prezzi valgono quando".
La validazione: il nodo che mi ha salvato più volte
Ecco il passaggio che distingue un'automazione affidabile da una bomba a orologeria. Tra l'estrazione e il salvataggio c'è un nodo Code con controlli stupidi ma spietati:
- I valori sono numeri, nei range plausibili del mercato? (un prezzo dell'energia a 47 €/kWh è un errore di parsing, non un'iperinflazione)
- La variazione rispetto al valore precedente è sotto una soglia ragionevole? Se il prezzo "cambia" del 300%, quasi certamente l'IA ha letto la colonna sbagliata
- I campi obbligatori ci sono tutti? Se un controllo fallisce, niente scrittura: mi arriva una notifica con l'email originale e l'estrazione proposta, e decido io. La filosofia è la stessa del panel di IA di cui ho scritto: quando l'automazione ha un dubbio, deve fermarsi, non tirare a indovinare. Un dato mancante si nota; un dato sbagliato in un preventivo firmato, molto meno.
Firestore: perché proprio lì
I prezzi finiscono su Firestore per un motivo semplice: è dove la mia applicazione già vive (Firebase). Un documento per fornitore, con i valori correnti, la decorrenza e lo storico delle versioni precedenti. Il preventivatore legge il documento e ha sempre i prezzi del giorno — nessuna sincronizzazione, nessun deploy, nessun "ricordati di aggiornare".
Lo storico è il dettaglio che si rivela prezioso dopo: quando un cliente chiede "ma il preventivo di ottobre com'era calcolato?", la risposta è una query, non un'archeologia di email.
La notifica: chiudere il cerchio con un umano
Ultimo nodo: un messaggio Telegram con il diff — "Listino X aggiornato: F1 da 0,142 a 0,138 (-2,8%), decorrenza 1/11". Dieci secondi di lettura, e so due cose: che l'automazione funziona, e come si sta muovendo il mercato. Un'automazione silenziosa è un'automazione di cui prima o poi smetti di fidarti; il report minimo quotidiano è il battito cardiaco che ti dice che è viva.
La lezione trasferibile
Il pattern email → estrazione IA → validazione → database vale per qualsiasi flusso in cui i dati arrivano in formato "umano": ordini, conferme, disdette, candidature. I tre principi da portarsi via:
- L'IA legge il formato libero meglio di qualsiasi regex — usala per l'estrazione, non per la matematica
- Mai fidarsi dell'estrazione senza validazione — i controlli di plausibilità costano dieci righe e valgono la tua reputazione
- Il dato estratto va dove l'applicazione vive — non in un altro silo da sincronizzare
Questo articolo fa parte della serie "Build in Public" su perfetti.tech — dove racconto quello che costruisco davvero, errori compresi.
Hai un problema simile?
Mandami due righe: ti dico se ha senso trasformarlo in uno strumento vero e quanto tempo serve.
ScrivimiAltri articoli
- Webhook n8n aperto a tutti? Come proteggerlo in 4 mosse
Un webhook n8n senza protezioni parte per chiunque conosca l'URL. Quattro mosse semplici, senza codice, per chiuderlo a chiave.
- Copertine con l'AI: automatiche, ma con l'occhio umano
Come ho dato una copertina a 21 articoli con l'AI e automatizzato le prossime: costi, colori da correggere, errori sui dettagli e controllo umano.
- Automazione n8n o agente AI? Quando usare cosa
Che differenza c'è tra un'automazione n8n e un agente AI? Spiegazione semplice, esempi per piccole attività e una guida su quando usare cosa.
Commenti
Ancora nessun commento. Scrivi il primo.